modlens 是什么?DeepSeek Harness 视觉多模态 DSH plugin 解析
modlens 是 DeepSeek Harness 的视觉外挂 DSH plugin:它给纯文本模型补上「看图」能力——粘贴图片即得结构化 JSON 证据,覆盖 OCR 文字、版面与语义(来源)。 这篇只解析这一个插件,按三个方向讲:它能做什么、怎么装怎么用、以及要不要为它付出 token 与隐私代价。
概览:一句话定位 modlens 这个 DSH plugin
它解决的是「模型是纯文本的,但你要它看截图」这一类需求。 把图片粘进对话,modlens 调用视觉模型把图片转成分字段的证据再交给主模型,而不是让主模型凭空猜图。它在插件市场里属工具 / 视觉类,已有 verified 标注。
| 维度 | 说明 |
|---|---|
| 解决的问题 | 纯文本模型无法直接读图 |
| 输出形态 | 结构化 JSON 证据(OCR / 版面 / 语义) |
| 安装 | 市场搜索安装,或 dsh plugin --profile web add @liustack/modlens |
| 配置 | 零配置即装即用,支持多模型密钥轮换与故障转移 |
它干什么:给纯文本的 DeepSeek Harness 外挂「看图」能力
核心机制是「转换」而不是「替代」——modlens 把图片变成文本证据,再让主模型基于证据推理。 三个要点:
- 粘贴图片即得结构化证据 — 你把截图或照片粘进对话,它返回分字段的 JSON,含识别出的文字、版面块与语义标签。预期:模型能引用图片里的具体文字与结构,而不是笼统描述。
- 自动发现并包装视觉路由 — 插件自动发现可用的视觉模型通道并包装成路由,把图片分派给对应模型。预期:不必逐个手工配置视觉模型。
- 零配置、可轮换密钥 — 即装即用,并支持多模型密钥轮换与故障转移。预期:某个密钥失效时自动切到备用通道。
一句话区分它与模型自带视觉:modlens 是「翻译官」,把图翻译成文字证据;模型自带视觉是「本人会看图」。 DeepSeek Harness 侧只有声明接受图片的模型才会直接收到图片(来源),这也是为什么纯文本模型需要 modlens 这类外挂。
怎么用这个 DSH plugin:安装、输入与和内置图像理解的关系
安装走标准插件通道,二选一:
- 图形化 — 打开插件市场,搜
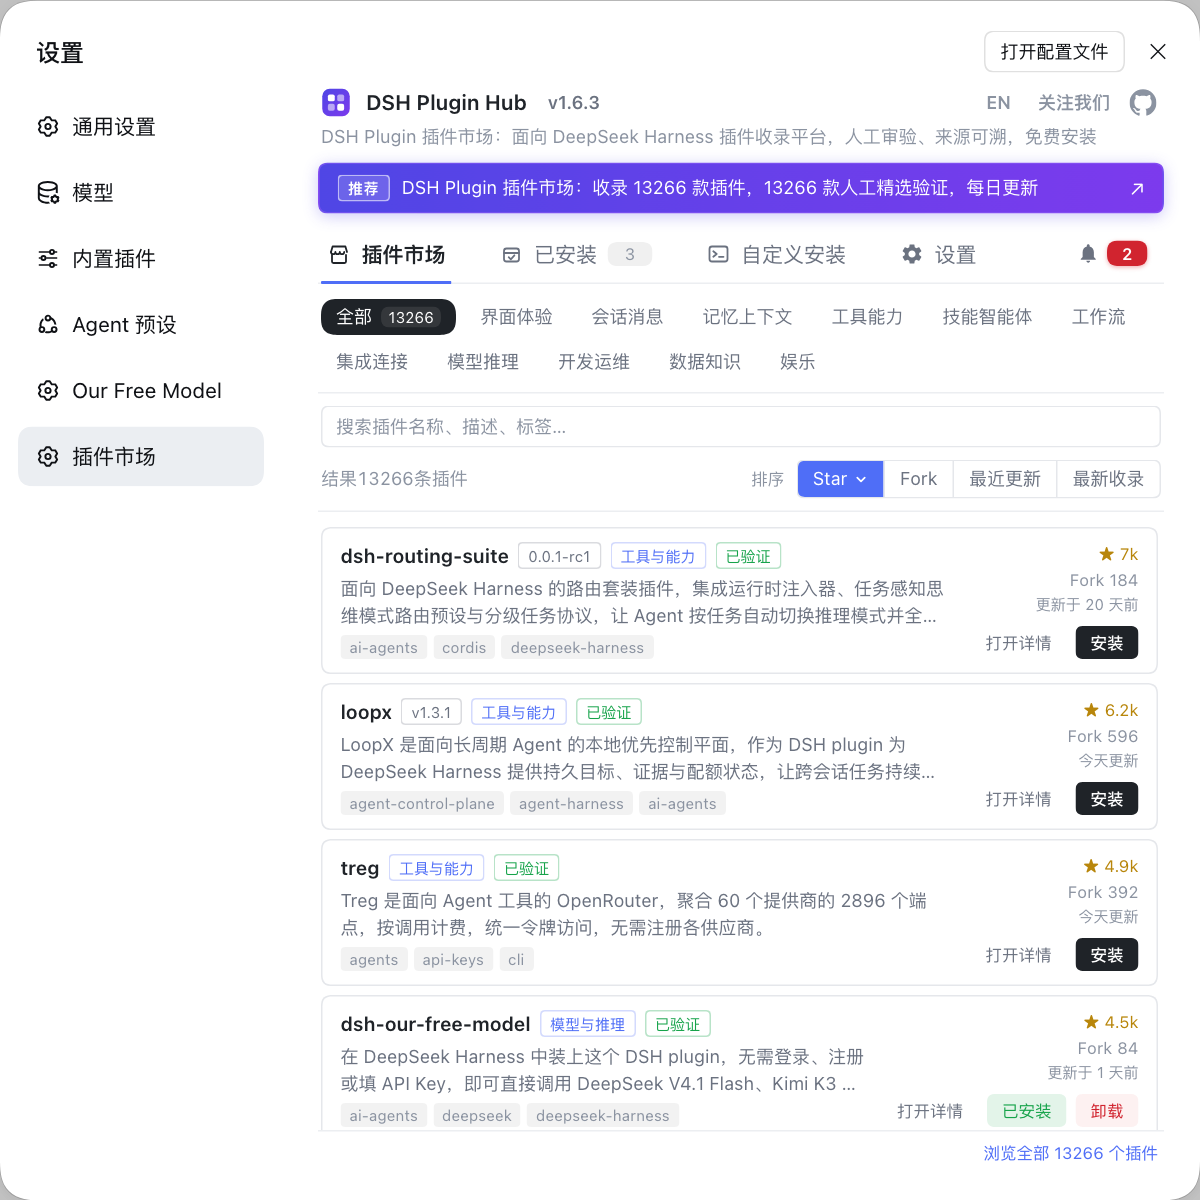
modlens,点安装。视觉 / 多模态类插件都在这里按分类找,入口是 DSH Plugin Hub。预期:已安装列表出现 modlens。 - 命令行 — 一条命令装完:
dsh plugin --profile web add @liustack/modlens
若要从源码装,官方也给出 GitHub 直装写法:dsh plugin --profile web add github:liustack/modlens。预期:重启 dsh web 后生效。
输入以图片为主(截图、照片)。装好后,把它与模型能力配合起来看:如果所用模型本身不吃图片,modlens 的价值就更突出——它负责把图转换成文本证据;如果你的模型已自带视觉,它能补的是结构化与版面这两个维度。两者的边界与配置要点见《DeepSeek Harness 图片理解》。
适用与代价:DeepSeek Harness 何时值得装 modlens、token 与隐私
判断标准很简单:看你的任务里「读图」是不是高频刚需。
- 值得装的场景 — 经常要模型读截图、表格图、报错图、票据图并据此推理。预期:省去手工把图里的字敲一遍。
- 不太值得的场景 — 偶尔贴一张图、或图片只是陪衬;此时额外调用与注入的文本反而累赘。预期:不装更轻。
- token 与延迟成本 — 看图这一步本身要调用视觉模型,图片先转成 JSON 证据再注入上下文,等于多一轮调用加一段文本。图片越多、分辨率越高,成本和延迟越明显。预期:批量高频看图前先估算。
- 隐私注意 — 视觉推理多由外部模型完成,图片内容会发往对应服务。涉及敏感信息的截图,先确认所用视觉模型的提供方与数据策略。预期:敏感图不外发或改用合规提供方。
使用 modlens 这个 DSH plugin 的注意事项
- 它不是模型模态开关:装 modlens 不会让纯文本模型声明接受图片,它只补「把图变成文本」这一步。
- 来源要看清:安装优先走市场或官方 npm 包名
@liustack/modlens,GitHub 直装可能遇到构建产物问题。 - 别把它当 OCR 工具单独用:它的价值在于把证据喂给主模型继续推理,脱离对话单独跑不如专用 OCR。
- 密钥要管好:多模型密钥轮换方便,但密钥本身要按敏感凭据管理。
- 先小样本试:正式接入前用几张真实图片验证识别质量与成本,再决定是否纳入日常流程。
来源:liustack/modlens、DeepSeek Harness 官方文档 - 配置模型、dshplugin/dsh-plugin-hub
常见问题
modlens 是 DeepSeek Harness 的视觉外挂 DSH plugin:为纯文本模型补上「看图」能力,你把图片粘进对话,它返回结构化的 JSON 证据,覆盖 OCR 文字、版面结构与语义理解。 它不改变模型本身的模态声明,而是把图片变成模型能读的文本证据。
安装走标准插件通道:市场里搜 modlens 点安装,或命令行 dsh plugin --profile web add @liustack/modlens。 主要输入是图片(截图、照片),零配置即装即用;官方还给出 dsh plugin --profile web add github:liustack/modlens 的 GitHub 直装写法。
不会。modlens 与模型内置图像理解是两回事:只有声明接受图片的模型才会直接收到图片,modlens 负责把图片转成结构化证据喂给纯文本模型。 模型能力与插件能力要配合,装了插件不等于模型模态被改写。
会,因为看图这一步本身要调用视觉模型:图片先被转成 JSON 证据,再把证据注入上下文,等于多了一轮调用与一段文本。 图片越多、分辨率越高,成本越明显;对一次性看几张图的任务通常可接受,高频批量看图要先评估。
要看图片是否离开本机:视觉推理多由外部模型完成,图片内容会发往对应服务。 涉及敏感信息的截图先确认所用视觉模型的提供方与数据策略;modlens 支持多模型密钥轮换,也意味着你可以指定合规的提供方。
相关术语
- modlens
- modlens 是 DeepSeek Harness 的视觉外挂插件(npm 包 @liustack/modlens),为纯文本模型提供看图能力,把粘贴的图片转成含 OCR、版面与语义的结构化 JSON 证据。— https://github.com/liustack/modlens
- 结构化证据(structured evidence)
- 结构化证据是 modlens 输出的形式:不再是一句图片描述,而是分字段的 JSON,包含识别出的文字、版面块位置与语义标签,便于模型在后续推理中直接引用。— https://github.com/liustack/modlens
- 视觉路由(vision routing)
- 视觉路由是 modlens 自动发现并包装可用的视觉模型通道的机制,插件据此把图片分派给相应模型处理,无需逐个手工配置。— https://github.com/liustack/modlens
- OCR
- OCR(Optical Character Recognition,光学字符识别)是把图片中的文字转成可编辑文本的技术,是 modlens 结构化证据里最基础的一层输出。— https://github.com/liustack/modlens
来源
- liustack/modlens GitHub 仓库· liustack
- DeepSeek Harness 官方文档 - 配置模型· deepseek-ai
- dshplugin/dsh-plugin-hub GitHub 仓库· dshplugin