DeepSeek Harness 上下文压缩异常:过早触发、切小模型卡死与 compact 报错
DeepSeek Harness(DSH)的上下文压缩有一套「看起来各自独立、实际同源」的故障:模型窗口明明 262K,跑到 186K 就自动压缩、而且压缩还很慢;从 1M 窗口模型切到 200K 窗口模型后整个会话卡死,每条请求都 400 而 /compact 也失败;上下文真溢出之后会话直接永久不可用;/compact 有时干脆报一句 imageRequestPricing is not a function;还有一条最隐蔽的——压缩每次悄悄多烧二十几万未缓存 token。 这些现象背后是同一套配置与三条实现细节:触发阈值是 min(W×0.8, W−O−headroom) 两个分支取小,而 headroomTokens 默认 65536 是绝对常量;构造摘要请求时不判断目标模型装不装得下、也不带会话的推理档;以及 tokenMeter 的适配器调用用可选链保护错了位置。本文按「什么时候压 → 压得动吗 → 花多少」三段把可改的配置逐项列出来(#9131、#9814、#9635、#9629、#9278)。
DeepSeek Harness 什么时候压:到达 186K 就触发,因为 headroom 是绝对值
一句话结论:触发点不是「窗口的百分之几」,而是 min(窗口×0.8, 窗口−输出预留−headroom) 两分支取小;headroomTokens 默认 65536 且不随窗口缩放,所以在中等窗口模型上先命中的往往是第二支。 报错/现象是「明明还有余量就开始压缩」,日志里会出现 summary is not smaller than the shadowed content 这类提示(#9131)。
据社区核对 README 与源码给出的公式与默认值:
| 项 | 默认值 | 说明 |
|---|---|---|
thresholdRatio | 0.8 | 第一分支的系数:窗口 × 0.8 |
headroomTokens | 65536(绝对) | 第二分支的减项,不随窗口缩放 |
输出预留 O | 约 6K | 按模型/路由声明 |
摘要 maxTokens | 默认 = headroomTokens | 也就是摘要一次最多可生成 64K(含推理 token) |
把 262K 代进去:第一支是 209.6K,第二支是 262K − 6K − 65.5K ≈ 190K——第二支更小,所以实际在约 190K 触发,与用户观察到的 186K 吻合(#9131)。
DeepSeek Harness 「压缩特别费时」的原因也在同一个默认值
maxTokens 默认等于 headroomTokens(65536),意味着摘要调用一次可以生成 64K token(含推理)——这是「压缩很慢」的主要来源,而不是压缩本身复杂(#9131)。
DeepSeek Harness 六项可改配置(都在 compaction 插件层)
- 调小
headroomTokens(例如 16384),让第二分支不再过早生效:
headroomTokens: 16384
- 让
thresholdRatio更靠近 1,但注意必须大于留存比例,否则会出现「刚压完立刻又触发」的抖动(#9131)。 - 按
{provider, model}单独覆盖,避免一套参数套在所有模型上:
modelPolicies:
  - provider: <你的 provider>
    model: <你的模型>
    headroomTokens: 16384
    thresholdRatio: 0.9
- 给摘要调用显式设一个较小的
maxTokens,直接削掉「压缩很慢」的主因(#9131)。 - 挂结果剪枝插件:
dsh-compaction-tool-result-pruner走的是「不调模型」的剪枝路径,能减少需要摘要的体量(#9131)。 - 或干脆关掉自动压缩:把自动档设成
auto: false,改为手动/compact,代价是要自己盯上下文(#9131)。
DeepSeek Harness 压得动吗:切到小窗口模型后会卡死
一句话结论:阈值会按目标模型的窗口重算(这一步是对的),但构造摘要请求时没有判断目标模型是否装得下**——它把整段历史原样发给「刚刚被切过去的那个小窗口模型」,于是摘要请求自己就超限、必然失败;而自动压缩路径还会静默吞掉失败,界面上只留一个上游 400。** 症状是从 1M 窗口模型切到 200K 窗口模型后,会话每条请求都失败,/compact 也一样失败(#9814)。
DeepSeek Harness 三步判据 + 两条处置
- 看症状时序:问题出现在「切换模型之后」而不是会话一直如此;切换前正常。这是本条最强的指纹(#9814)。
- 确认失败的是摘要请求而不是主请求:如果主请求体量本身没超窗口,却在切模型后立刻 400,那基本就是摘要这一路在炸(#9814)。
- 处置一:把摘要 provider 固定到大窗口模型。
summarizationProvider:
  provider: <大窗口 provider>
  model: <大窗口 model>
注意:这只是止血——如果历史本身已经超过所有可用模型的窗口,死锁依旧存在(#9814)。
- 处置二:装按声明窗口改投更大路由的社区插件
@argszero/dsh-compaction-target-guard,它在摘要被拒后按 declared window 换一个装得下的路由重试:
npm i @argszero/dsh-compaction-target-guard
- 注意声明窗口可能与真实不符:如果 provider 声明的窗口大于服务端实际限制,本条的判断会继续错下去,需要一并核对(#9814)。
DeepSeek Harness 溢出之后:会话为什么「永久」不可用
一句话结论:三层机制叠加——本地压力估算低估真实 prompt、摘要把整段影子区原样重放给刚溢出的同一路由、产品内又没有强制的恢复入口——于是溢出一次就再也压不动。 典型错误串是 CONTEXT_WINDOW_EXCEEDED 与 Compaction could not produce a useful summary(#9635)。
三层拆开看(据报告者给出、社区逐条核对源码确认):
- 估算偏差:本地压力启发式会低估真实 prompt 体量(讨论中给出的量级约为
0.67×),所以「看起来还没超」的时候其实已经超了; - 重放自伤:摘要请求会把整个影子区原样重放给刚刚溢出的同一个路由——重放是
summarizer.ts的有意设计(为了复用 KV cache),代价是摘要请求自身也超限; - 没有手动出口:产品内没有
/compact --force、也没有非 LLM 的强制截断路径,所以一旦进入这个状态,用户没有可点的恢复按钮(#9635)。
DeepSeek Harness 四步自救
- 固定一个大窗口模型做摘要(同上一节的
summarizationProvider)——让摘要请求能被接住。 - 装溢出恢复类插件
@argszero/dsh-overflow-recovery:它在被拒后丢弃最旧的可丢区段再重试,属于「有损但能续命」的路线(#9635)。
npm i @argszero/dsh-overflow-recovery
- 离线手术:直接编辑该会话的 JSONL,把最旧的可丢区段删掉,再重新打开会话。务必先备份,并保持剩下事件的顺序与编号不变(#9635)。
- 预防性配置:把
headroomTokens按比例调小、把thresholdRatio调晚、挂工具结果剪枝插件,避免真的走到溢出(回到本文第一节)。
DeepSeek Harness 压得贵吗:摘要请求差一个推理档,缓存命中掉到 1%
一句话结论:摘要请求在构造时没有带上与会话一致的 reasoning_effort,于是它的缓存键与主请求不同,后半段完全没命中缓存——每次压缩额外产生约 25 万未缓存 token。 把摘要请求的推理档改成与会话一致后,命中率从 1.2%~8% 提升到 99.9%(#9629)。
据社区核对源码:compaction-basic 的摘要构造代码里完全没有 reasoningEffort 这个字符串,而主请求会带上会话的 effort,两边缓存键不一致(#9629)。
处置步骤:
- 先量化:对比一次压缩前后的用量统计,观察「未缓存输入 token」是否出现一个数量级上的尖峰(讨论中的量级是每次约 25 万)。
- 回填推理档:装社区插件
@argszero/cordis-plugin-aux-reasoning,它按purpose标记给辅助调用回填与会话一致的推理级别:
npm i @argszero/cordis-plugin-aux-reasoning
- 验证:再触发一次压缩,观察未缓存输入 token 是否显著下降、缓存命中率是否上到九成以上。
- 注意结论边界:报告者并未主张「上游缓存键一定这么算」,只主张 A/B 现象成立——所以把它当可复现的优化而不是定论(#9629)。
DeepSeek Harness 压不动:/compact 报 imageRequestPricing is not a function
一句话结论:可选链 ?. 只保护「适配器不存在」,不保护「适配器存在但没有实现这个方法」,于是一个鸭子类型注册的第三方适配器就能让 tokenMeter 在图片计价阶段抛 TypeError,压缩整体失败。 报错原文是:
command.execute failed: gateway/internal: this.adapters.get(...)?.adapter.imageRequestPricing is not a function
据报告者分析(社区复核认可):这与具体是哪个插件无关——把视觉类与搜索类插件卸掉仍然复现,说明它命中的是「某个适配器缺方法」而不是「某个插件写错了」(#9278)。
DeepSeek Harness 三步处置
- 先确认不是插件引起的:临时禁用视觉/搜索类插件后重跑
/compact,若仍报同一句,即可排除单插件因素(#9278)。 - 装守卫插件绕过:报告者发布了
c6huli/dsh-llm-pricing-guard,把「适配器没有这个方法」当作「无图片计价」处理(#9278)。 - 代码侧正解方向:把
?.换成typeof … === 'function'守卫并保留this绑定,同时让tokenMeter把缺方法视为无图片计价(#9278)。
DSH插件 排查注意事项
压缩类问题的排查顺序建议是:先看「触发时机」→ 再看「摘要发给了谁」→ 最后看「花了多少」,这三步对应本文三节,别混着改配置。 九条要点:
headroomTokens是绝对常量:它不随窗口缩放,这是「中等窗口过早压缩」的根本原因(#9131)。thresholdRatio不能等于留存比例:调得太晚会出现压缩抖动(刚压完又触发)(#9131)。- 摘要默认
maxTokens也跟着 headroom 走:这是「压缩很慢」的直接原因,显式设小最有效(#9131)。 - 切模型后卡死优先怀疑摘要目标:阈值重算没问题,问题在摘要没判断装不装得下(#9814)。
- 重放是设计不是 bug:理解这一点,才不会「等官方修掉重放」(#9635)。
- 溢出后先备份再动 JSONL:离线删区段是可行的自救,但没有备份就没有退路(#9635)。
CONTEXT_WINDOW_EXCEEDED≠ 额度用尽:两者文案相近、含义完全不同,别照着「充值」的方向修(#9635)。- 压缩变贵先查推理档:摘要请求缺
reasoningEffort是缓存失效的根因,量级可达每次 25 万 token(#9629)。 - 修复状态如实:以上五条在讨论所指版本(
0.2.0-rc.2~0.2.1-alpha.*)里都未修;本文给出的都是配置级与用户侧处置(调参、固定摘要 provider、剪枝插件、离线删区段),不是官方修复。
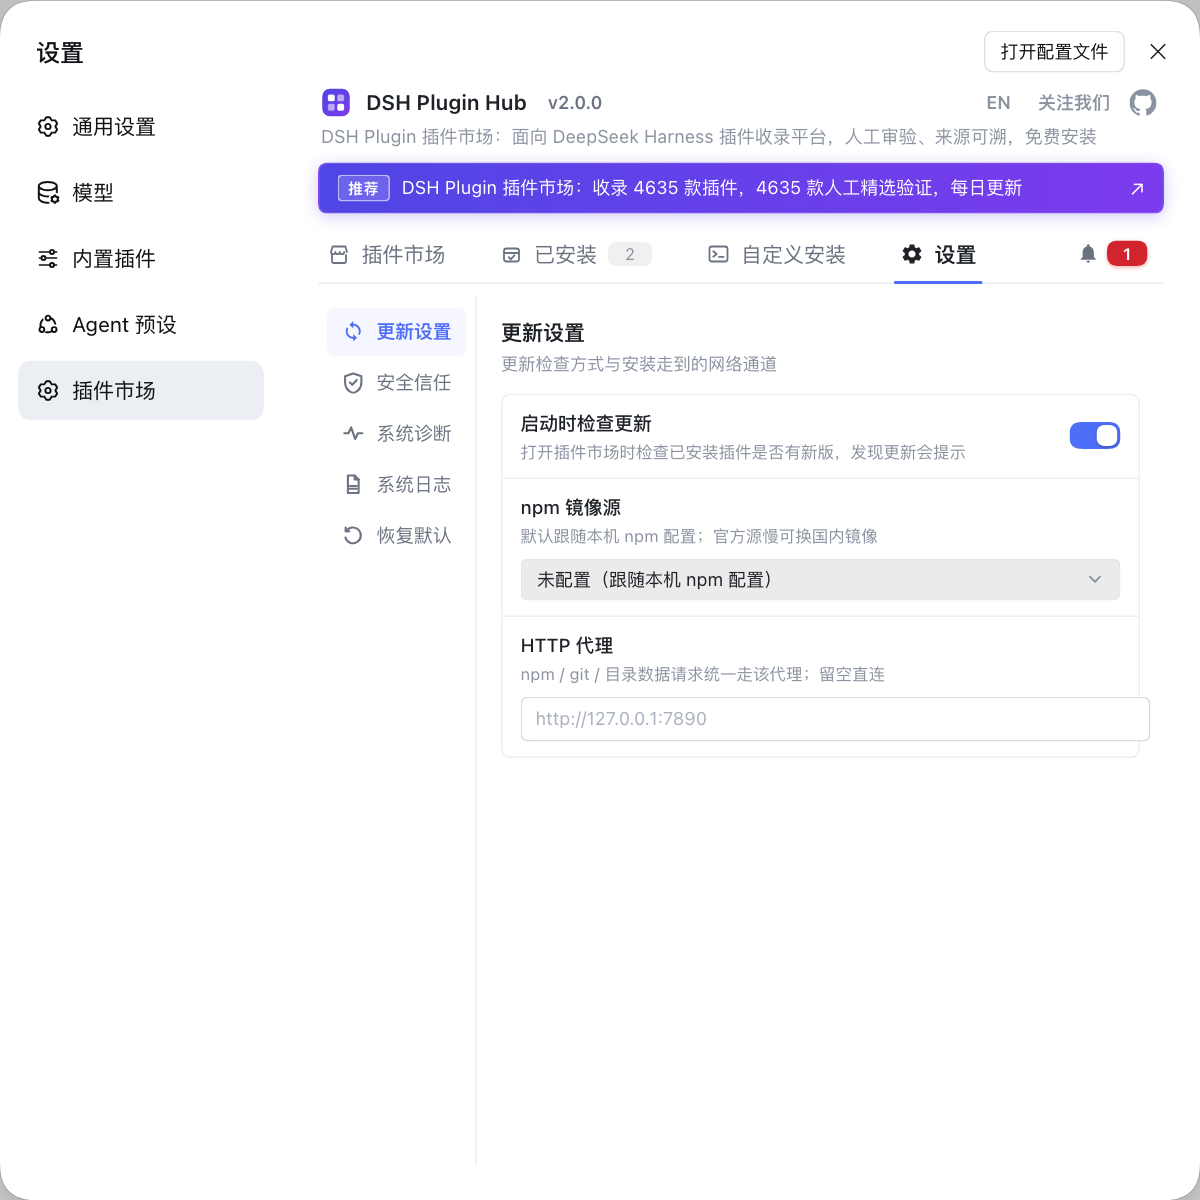
压缩这类问题往往和「插件装了什么」纠缠在一起——毕竟摘要 provider、剪枝插件、计价守卫都是插件形态。如果你想先在界面上把当前环境挂了哪些插件、最近有没有装卸看清,与其在各处手敲命令,不如用 DSH Plugin Hub 这类可视化插件市场:已安装列表、装卸历史与系统日志集中在一处,排配置冲突会快不少。
来源:Discussion #9131、Discussion #9814、Discussion #9635、Discussion #9629、Discussion #9278。
常见问题
DeepSeek Harness 在 186K 就自动压缩,是因为触发阈值不是单一的百分比,而是 min(窗口×0.8, 窗口−输出预留−headroom) 这两个分支取小,而 headroomTokens 默认是 65536 的绝对常量、不随窗口缩放。按公式反推,186K 说明生效的是第二支而不是 0.8 那一支。想让它晚点触发,改配置里的 headroomTokens(例如调到 16384)并让 thresholdRatio 更靠近 1。
DeepSeek Harness 切小窗口后卡死,是因为压缩摘要请求被发给了目标模型自己。阈值会按目标模型的窗口重算(这一步是对的),但构造摘要请求时没有判断目标模型装不装得下整段历史,于是摘要请求携带整段历史再发给一个小窗口模型,必然超限;而自动压缩路径还会静默吞掉失败,界面上只看到上游 400。缓解办法是把摘要用的 provider 固定到大窗口模型,或使用按声明窗口改投更大路由的社区插件。
DeepSeek Harness 溢出后不可用有三层原因叠在一起:本地压力估算低估真实 prompt、摘要把整段影子区原样重放给刚溢出的同一路由、以及产品内没有强制截断的恢复入口。可行的自救是固定一个大窗口模型做摘要、使用溢出恢复类插件,或离线直接改会话 JSONL 把最旧的可丢区段删掉再重开。注意重放是刻意的设计(为了复用缓存),不是单纯的 bug。
DeepSeek Harness 的 /compact 报 imageRequestPricing is not a function,是可选链用错位置的典型:?. 只保护「适配器不存在」,不保护「适配器存在但没有实现这个方法」。第三方插件用鸭子类型注册适配器、不带图片计价方法时,tokenMeter 在解析图片计价阶段就抛 TypeError,与哪个插件无关(把视觉与搜索类插件卸掉仍然复现)。绕过办法是装一个把缺失方法当「无图片计价」处理的社区守卫插件。
DeepSeek Harness 压缩每次都多花二十几万未缓存 token 并不正常。压缩摘要请求构造时没有带上与会话一致的 reasoning_effort,导致它的缓存键与主请求不同、后半段完全没命中缓存。讨论中实测把摘要请求的推理档改成与会话一致后,缓存命中率从 1.2%~8% 提升到 99.9%,单次压缩省下约二十几万未缓存 token。处置方式是用辅助调用回填推理级别的社区插件,或直接给摘要 provider 固定同一档位。
相关术语
- headroomTokens
- headroomTokens 是 DeepSeek Harness 压缩配置里为「留给后续输出」预留的 token 数,默认 65536,且是一个不随模型窗口缩放的绝对常量。它与 thresholdRatio 共同决定自动压缩的触发点,也常被用作摘要调用的输出上限。— https://github.com/deepseek-ai/deepseek-harness/discussions/9131
- ThresholdRatio(压缩触发比例)
- thresholdRatio 是压缩触发阈值里的比例系数,与 headroomTokens 一起参与 min(窗口×比例, 窗口−输出预留−headroom) 的计算。它越接近 1,压缩触发越晚;但必须留出比留存比例更大的余量,否则会出现刚压缩完又立刻触发的抖动。— https://github.com/deepseek-ai/deepseek-harness/discussions/9131
- summarizationProvider
- summarizationProvider 是执行压缩摘要时使用的模型路由。它独立于当前会话模型,因此可以被固定到一个窗口更大的模型上;当会话模型窗口过小时,是否把它固定到大窗口模型直接决定压缩能否完成。— https://github.com/deepseek-ai/deepseek-harness/discussions/9814
- CONTEXT_WINDOW_EXCEEDED
- CONTEXT_WINDOW_EXCEEDED 是「输入加输出超过模型窗口」时返回的错误码,属于超限类失败而非额度不足。它也是上下文溢出的判据之一,与「额度已用尽」是完全不同的含义。— https://github.com/deepseek-ai/deepseek-harness/discussions/9635
来源
- #9131 — 262K 的上下文,为什么每次执行到 186K 就开始自动压缩· deepseek-ai(GitHub Discussions)
- #9814 — 从大上下文窗口模型切到小窗口模型会卡死:压缩请求自己也超限· deepseek-ai(GitHub Discussions)
- #9635 — [compaction bug] Session becomes permanently unusable on context overflow· deepseek-ai(GitHub Discussions)
- #9629 — 压缩摘要缺 reasoningEffort 导致缓存命中率掉到 1%,每次压缩多花约 25 万未缓存 token· deepseek-ai(GitHub Discussions)
- #9278 — DSH 0.2.0-rc.2 压缩上下文失败:imageRequestPricing is not a function· deepseek-ai(GitHub Discussions)